
本文仅记录个人技术学习过程,项目不存储任何视频资源,请支持正版,遵守相关站点协议。
作为一个喜欢看动漫的人,以前每季度最低也要追二十多部动漫。但是众所周知,由于国内审核原因,很多动画不能播,也无法回到以前的大盗版时代。
对于以前在高中手机被父母没收,只有旧二手手机(例如红米 Note 1 增强版),甚至用智能儿童手表看动漫的高中生——就是如图这玩意:
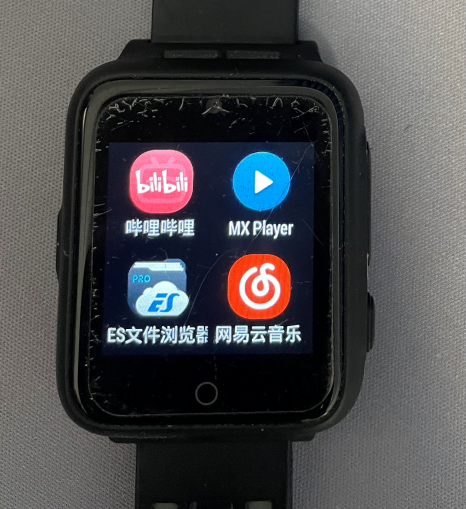
那时候,我经常琢磨如何流畅且可迁移地去看带弹幕的动画。最后的方案就是使用 X 浏览器解析 AGE 动漫或者 HaliHali 动漫的视频,放到外部播放器弹弹play加载弹幕观看。当然,用手表则使用 MX Player。
而且弹弹play强大的弹幕库,对于以前已经下架的老番也依旧有大量弹幕,并且还会采集巴哈姆特等地方的弹幕。
一、 目标
虽然现在能看的方法很多,我的新手机和电脑现在也不离身,但是仍然想做一个可以直接把网络动漫和弹幕在一个网站上匹配的网站。
以前高中琢磨过苹果CMS,这次则想直接全部重新写。采用前端 Vue、后端 Node.js、数据库 MongoDB 的方法。前端采用 Vuetify 3 这个 UI 框架,顺便也用 Node.js 直接重写一个苹果CMS采集接口,以便于采集兼容苹果CMS的网站。当然,作为大二学生技术力不太够,写着玩。
为啥不搞种子下载存动漫? 没有这么强大的服务器,甚至流量对我来说都很珍贵。那么项目的目标很明确了:轻量和便于迁移。
所以,能白嫖的就白嫖,视频源、弹幕源、服务器统统白嫖。
二、 搞定弹弹play开发者权限
先说一下我认为迫切要解决的点吧。我不认识弹弹play的开发者,第一步就卡死了,所幸弹弹play有一套完整的开发者平台。
直接给官方人员发邮件,拿到了 AppId、AppSecret1 和 AppSecret2(任选一个用)。
三、 采集接口
然后是采集接口。对于刚刚学习了 Node.js 的我,感觉强的可怕,但是很明显,被各种采集问题吓哭了。采集间隔、采集失败的处理机制等等各种东西,实际写起来还挺麻烦的,一直在调试,代码反而是次要的了。
由于模仿苹果CMS写,所以使用宝塔定时访问采集接口来采集:
- 每个采集站可能只有 JSON,也可能只有 XML,我直接把 XML 转成 JSON;
- 而且每个网站的动漫分类 ID 也不同,我直接肉眼先确定各个采集网站的动漫分类 ID,写到了一个 typelist 数组;
- 先发送一次请求,页码留空,然后拿总页数;
- 然后遍历分类、遍历分页、遍历每部动漫的视频数组。
setTimeout 设置成 1 秒让它慢慢采集。每一页采集完成,我还套了一个 await sleep(1000) 让它歇一秒,主要是被之前光速采集问题一堆给整怕了,反正凌晨采集。如果只采集过去一天的东西,几分钟一个站点就采集完成了。
数据库存的东西确实比较简单,只有标题名、图片链接和视频链接。因为不同采集站的参数都不太一样,把这些东西融合到一起有点太乱了,而且参数很多很多,不符合简洁的目标。
四、 选播放器和弹幕功能
我需要找一个可以加载弹幕的播放器,我不想造一个这样的轮子,最终敲定了 NPlayer。当然,这东西也是一个大坑。
后面写弹幕相关功能的时候倒是很正常:使用搜番剧、拿集数、然后拉弹幕,后端的 AppSecret 也加密了一下。
另外,我在播放器的弹幕方面加入了一个“弹幕时间轴微调”功能。为什么呢?因为“澳门新葡京”,导致了弹幕会严重偏移。
五、 尾声
后面还有 NPlayer 播放器的坑,遇到的坑真是一环接一环。
反正最后前后端部署到宝塔正常跑起来了,也修了不少 Bug。博客写不下去了,就写到这吧。
附:来自“未来人”的更新
前端页面在目前基本完善,体验还不错,还借助了ai写了一份手势操控的状态机,弥补一下NPlayer相关的不足,后端倒是没怎动。